
問題
システムが時間とともに図のように故障と回復を繰り返した。このとき,RASISの信頼性(Reliability)と可用性(Availability)を表す指標の組合せとして,適切なものはどれか。ここで,T=(1/n)×(t₁+t₂+…+tₙ),S=(1/n)×(s₁+s₂+…+sₙ) とする。 (図)稼働時間 t₁ のあと1回目の故障,修理時間 s₁ のあと回復,稼働時間 t₂ のあと2回目の故障 … 稼働時間 tₙ のあと n 回目の故障,修理時間 sₙ のあと回復。
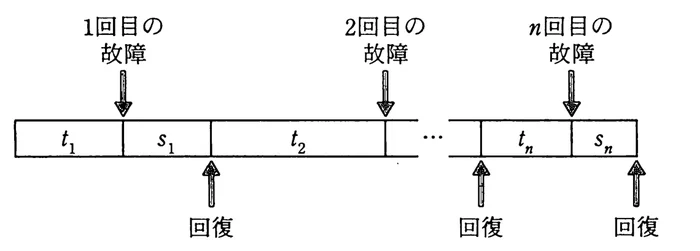
図の出典:出典:IPA(情報処理推進機構)公式 基本情報技術者試験 平成22年度秋期 午前 問17
キーボード:1〜4で選択・Enterで次へ
答え合わせ
- A
- B
- C
- D
自信の3択
えらぶと、この端末に記録します(登録はいりません)
解説
答えは b「信頼性:T 可用性:T/(T+S)」 です。
RASISの2指標:
- 信頼性(Reliability):故障せず動き続ける時間の平均=MTBF=T(平均稼働時間)
- 可用性(Availability):全体時間のうち動いている割合=T÷(T+S)(Sは平均修理時間=MTTR)
図のT=動いてた時間、S=修理時間。これを当てはめます。
👉 覚え方:「信頼性=MTBF(壊れずに動く時間)」「可用性=MTBF÷(MTBF+MTTR)(動いてた割合)」。
ほかの選択肢:a 可用性を S(修理時間の平均)にしている/c・d 信頼性を T+S(稼働時間と修理時間の合計)にしている。RASIS=Reliability/Availability/Serviceability/Integrity/Security の5指標、最初の2つが最重要!
なぜこれが正解か
正解は b。RASISの主要指標:
- 信頼性(Reliability)=MTBF(Mean Time Between Failure、平均故障間隔)。図中の T が稼働時間で、これがMTBFに相当。
- 可用性(Availability)=稼働率=MTBF÷(MTBF+MTTR)=T÷(T+S)。Sは平均修理時間(MTTR: Mean Time To Repair)。
この組合せが b に該当する。
各選択肢の解説
- a:信頼性 T は正しいが、可用性を S(平均修理時間)としている。S は停止している時間の平均で、稼働率ではない。
- b:信頼性=T(MTBF),可用性=T/(T+S)(稼働率)(正解)。
- c:信頼性を T+S としている。故障から次の故障までの時間全体で、故障せずに動く時間の平均ではない。可用性 S も誤り。
- d:可用性 T/(T+S) は正しいが、信頼性を T+S としている点が誤り。
覚え方・ひっかけ注意
RASIS=Reliability(信頼性)/Availability(可用性)/Serviceability(保守性)/Integrity(保全性)/Security(機密性)。「信頼性=故障しない時間の長さ、可用性=動いてる時間の割合」。「故障しても可用性は維持可能」(冗長化)が応用問題の典型。
理論的背景
システム信頼性工学の基本指標:MTBF=Σ稼働時間/故障回数、MTTR=Σ修理時間/故障回数、MTTF(Mean Time To Failure、修理不可能システムの平均寿命)。稼働率A=MTBF/(MTBF+MTTR)。信頼度関数R(t)=e^(-λt)(故障率λが一定の指数分布仮定)。直列システム:R = ΠR_i(全要素が動く必要、稼働率は積)、並列システム:R = 1-Π(1-R_i)(どれかが動けばOK、稼働率は1-(1-x)(1-y))。バスタブ曲線(初期故障期→偶発故障期→摩耗故障期)はハードウェア故障率の古典モデル。ワイブル分布は故障時間の柔軟なモデルで、形状パラメータβにより上記3期間を表現可能。
実務での使われ方
SLA(Service Level Agreement)の可用性指標:99%(Two Nines)=年間87.6時間停止、99.9%(Three Nines)=年間8.76時間、99.99%(Four Nines)=年間52.6分、99.999%(Five Nines)=年間5.26分、99.9999%(Six Nines)=年間31.5秒。Webサービスは通常Three〜Four Nines、ミッションクリティカル系はFive Nines以上を目指す。SLO(Service Level Objective、内部目標)、SLI(Service Level Indicator、測定指標)はSRE(Site Reliability Engineering、Google発祥)の基本概念で、Error Budget(許容停止時間予算)でリスクテイク判断する。
試験での位置づけ
FE科目AでRASIS・稼働率計算が定番。応用情報・ITサービスマネージャ・ネットワークスペシャリストでは直列/並列稼働率、冗長構成(N+1、2N、2N+1)の稼働率計算、保守性指標(MTTR短縮策)、可用性設計(高可用性HA、フォールトトレラント、災害復旧DR)が深く問われる。データセンタTier I〜IV(Uptime Institute)、ITIL 4の可用性管理プロセスとも関連。
選択肢の発展補足
信頼性設計の発展:FMEA(Failure Modes and Effects Analysis、故障モード影響解析)/FTA(Fault Tree Analysis、故障の木解析)/HAZOP(HAZard and OPerability Study)/RBD(Reliability Block Diagram)/Markov Reliability Model(修理可能システム)。SRE実践:Error Budget Policy(予算超過時のリリース凍結)、Toil削減(運用作業の自動化)、Postmortem(非難なき事後分析)、Chaos Engineering(意図的障害注入で耐性検証)。MTTRよりMTTD/MTTI/MTTC(Detection/Identification/Containment)が現代の重視指標で、観測可能性(Observability、Three Pillars:Metrics/Logs/Traces)の運用基盤が必須。NIST SP 800-160、ISO/IEC 25010(システム品質特性、信頼性は8特性の1つ)も基礎規格として押さえる。
出典と作り方
出典:IPA(情報処理推進機構)公式 基本情報技術者試験 平成22年度 秋期 問17/ 公的機関配布資料につき出典明記の上引用。解説は合格ナビ独自の3段階の解説(初級・標準・上級)です。
